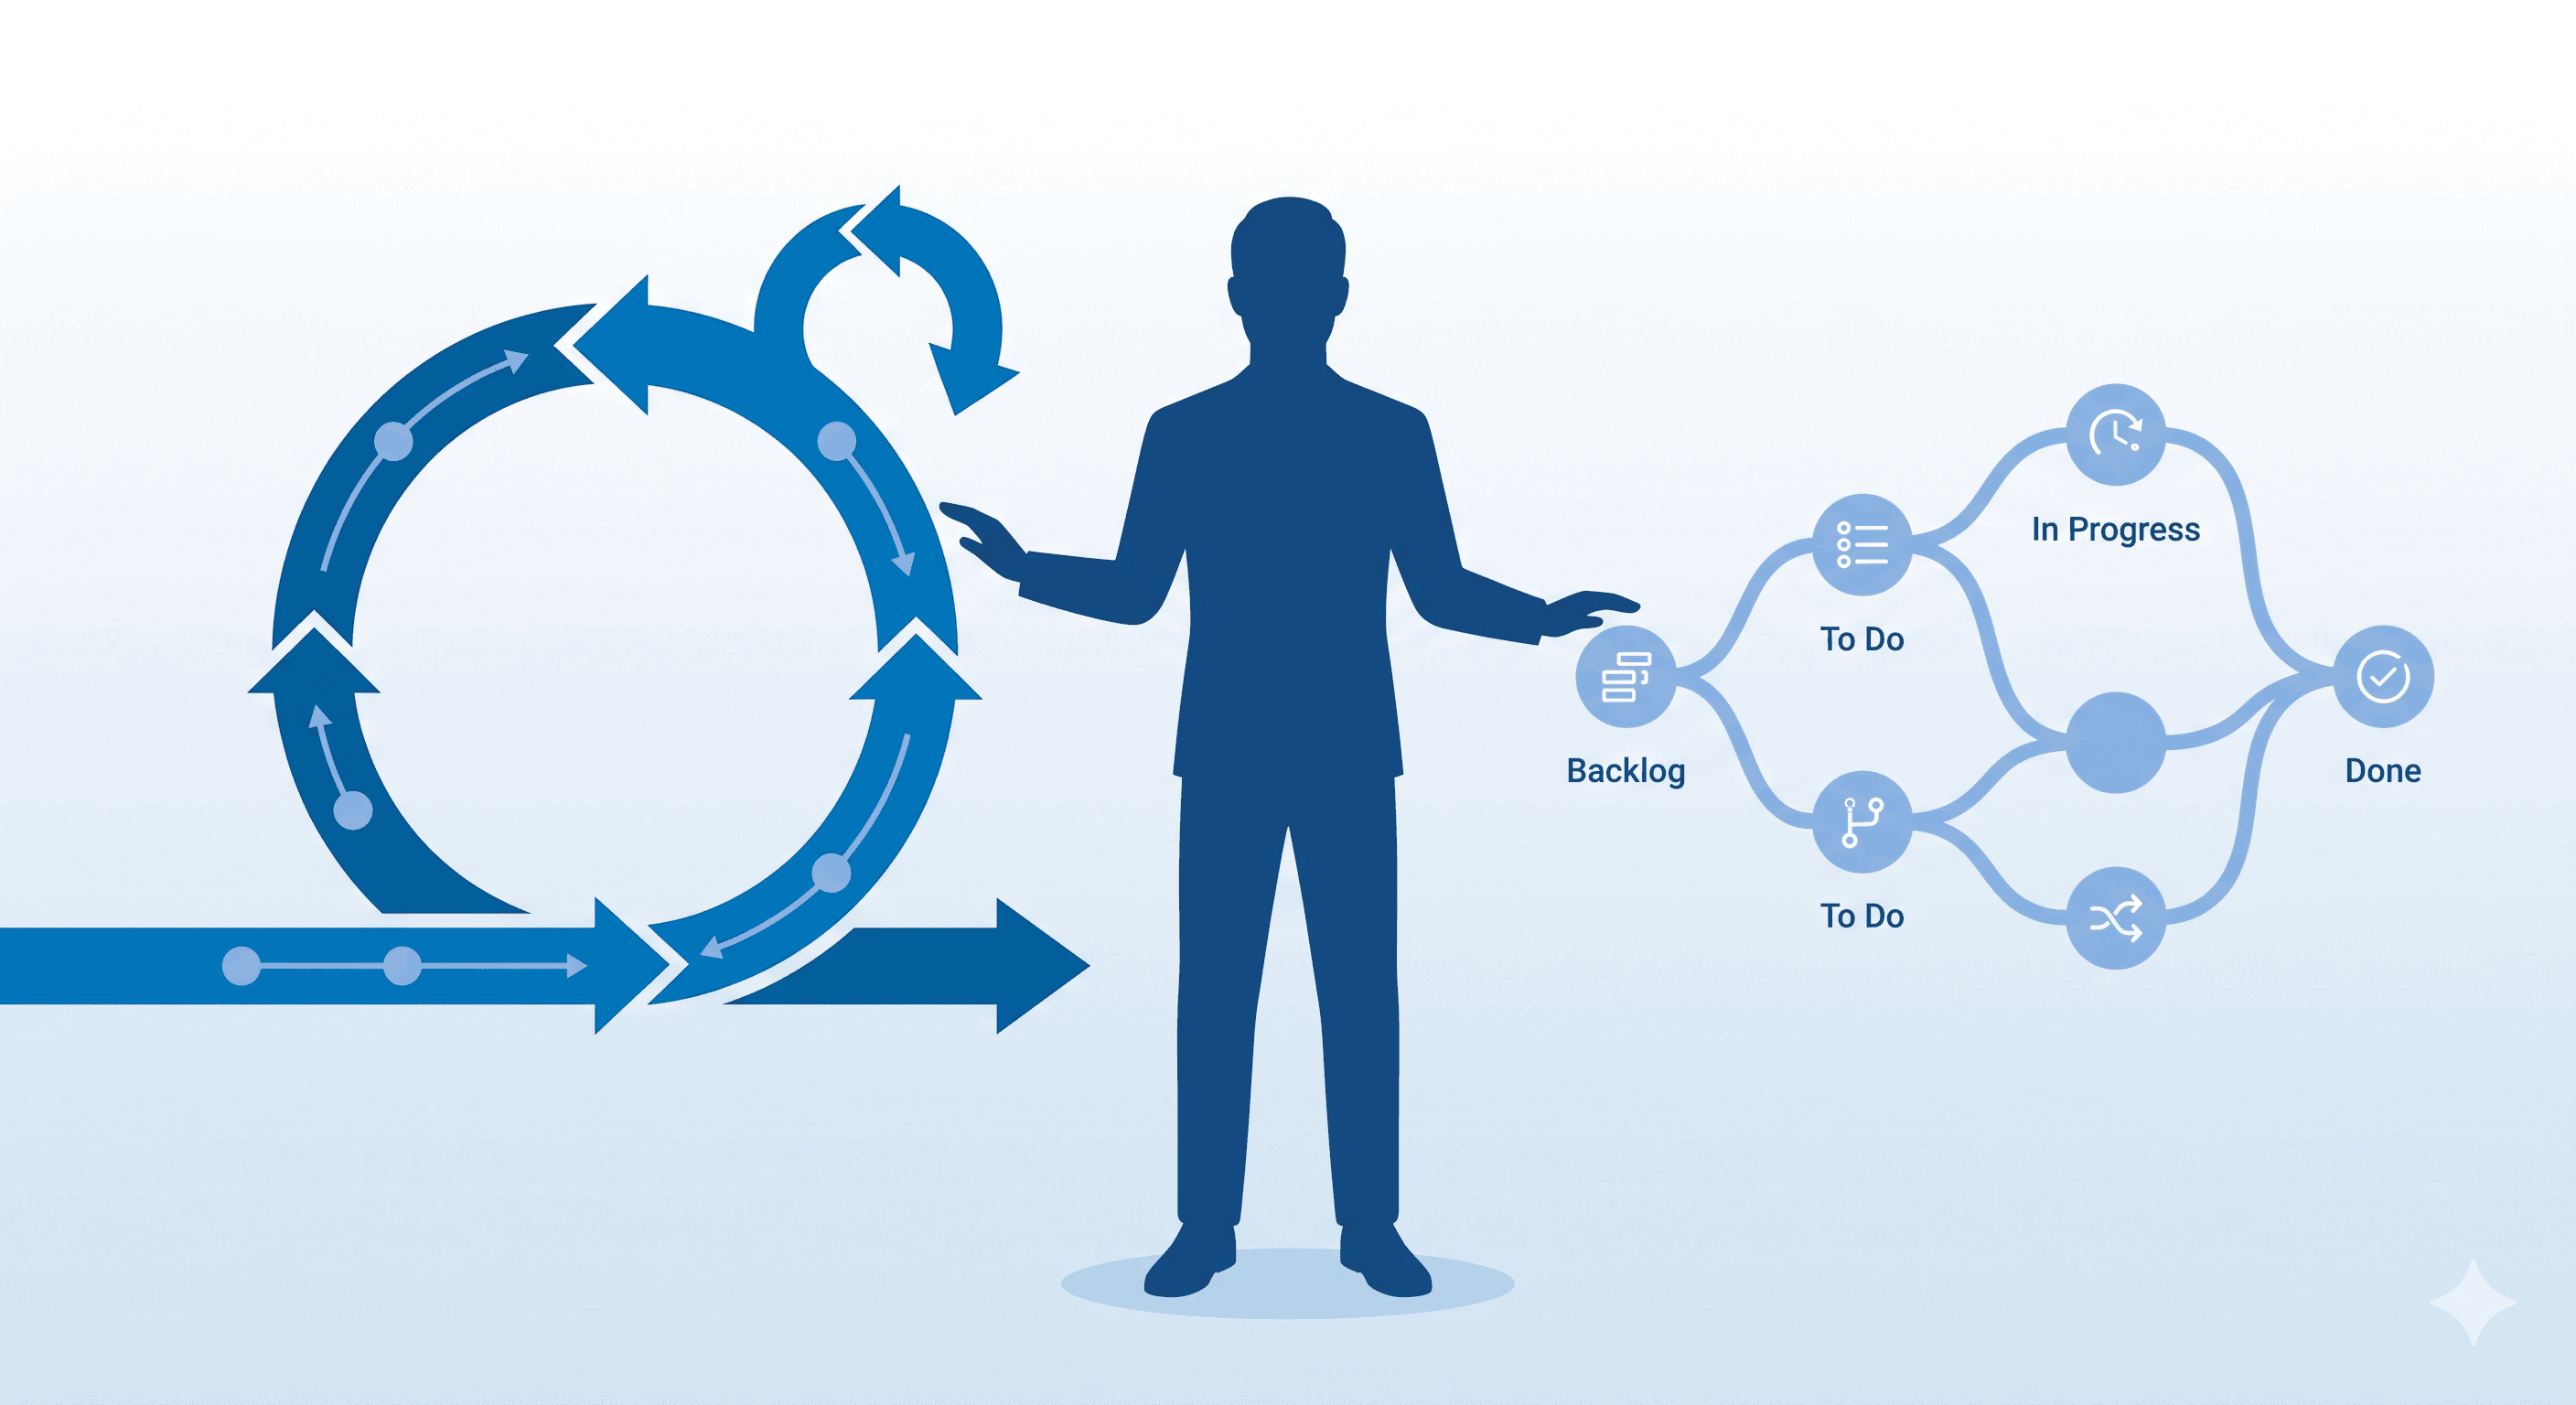
مشروع Data Science ليس مشروع برمجيات.
نعم، فيه كود. وفيه فريق. وفيه متطلبات. لكنه مختلف في جوهره: أنت لا تبني شيئًا محددًا من البداية، بل تستكشف. والاستكشاف لا يسير على خطط ثابتة.
ومع ذلك، كثير من الفرق تحاول تطبيق الـ Scrum بشكله الكلاسيكي على مشاريع Data Science.
والنتيجة؟ إحباط متبادل بين الفريق والـ Stakeholders.
لماذا تفشل الـ Sprints في مشاريع الـ Data Science؟
الـ Sprint الكلاسيكي يفترض أنك ستسلّم Increment قابل للاستخدام كل أسبوعين.
لكن في مشاريع البيانات والذكاء الاصطناعي:
١. الاستكشاف لا ينتج دائمًا ناتجًا قابلًا للتسليم.
قد تقضي Sprint كاملة في تحليل البيانات وتكتشف أن الافتراض الأساسي خاطئ. هل هذا فشل؟ لا. لكنه لا يُعرَض في Sprint Review بسهولة.
٢. تعريف الـ Definition of Done ضبابية.
"النموذج يعمل" ليست Acceptance Criteria واضحة. ما دقة النموذج المقبولة؟ على أي Dataset؟ في أي بيئة؟
٣. تدريب النماذج لا يتسع في أسبوعين.
بعض نماذج الـ Machine Learning تحتاج أيامًا من التدريب. Sprint بأكملها قد تكون تجربة واحدة فاشلة.
٤. المتطلبات تتغير بناءً على البيانات نفسها.
لا تعرف ما ستحتاجه حتى تنظر في البيانات. هذا يعني أن Backlog ثابتًا من بداية المشروع هو وهم.
هل هذا يعني التخلي عن الـ Agile؟
لا. بل يعني التكيّف معه.
الـ Agile مبادئ، ليست طقوسًا ولكنه منهجية فكرية. والمبدأ الأساسي هو الاستجابة للتغيير بدلًا من اتباع خطة جامدة. وهذا تمامًا ما تحتاجه مشاريع الـ Data Science.
المشكلة ليست في Agile. المشكلة في تطبيق Scrum بشكل حرفي على سياق لم يُصمَّم له.
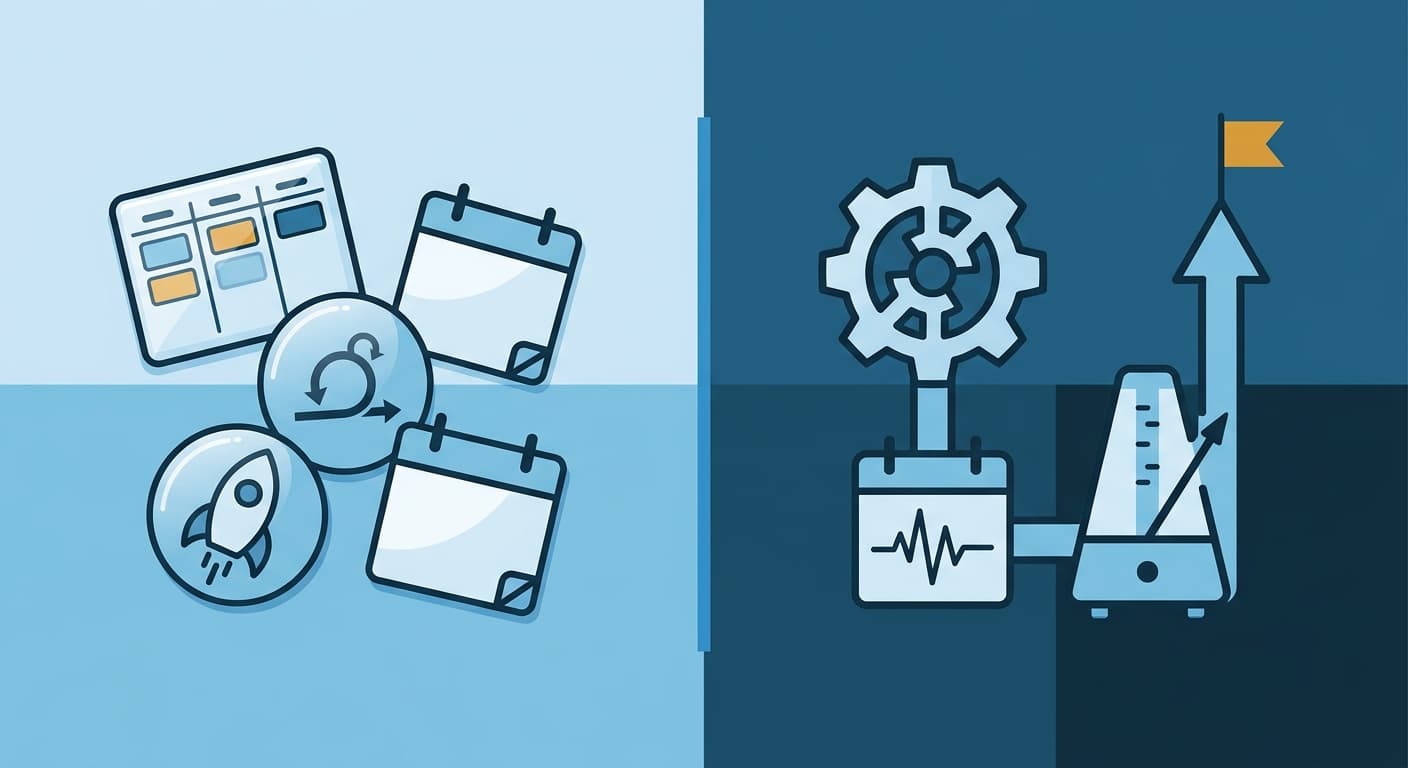
الإطار العملي: متى تستخدم Sprints؟ ومتى تستخدم Kanban؟
مشاريع Data Science تمر بمرحلتين مختلفتين جوهريًا:
المرحلة الأولى: الاستكشاف والبحث (Exploration Phase)
هنا Kanban أفضل.
العمل غير متوقع، والمهام تنبثق من بعضها، والـ Flow هو ما يهمك لا الـ Velocity. استخدم Board بسيطًا: To Do, In Progress, Done. وضع WIP Limits لتجنب التشتت.
المرحلة الثانية: البناء والنشر (Build and Deploy Phase)
هنا Sprints تعمل بشكل ممتاز.
عندما يكون النموذج جاهزًا للتطوير والدمج في المنتج، تصبح المتطلبات أوضح والـ Deliverables أكثر قابلية للتنبؤ.
أدوات تساعدك على التكيّف
Spike Stories
مهام بحثية داخل الـ Backlog هدفها الوصول إلى إجابة لا إلى ناتج.
مثال: "ابحث في ثلاث تقنيات مختلفة لتنظيف البيانات وقدّم توصية." هذا Sprint-ready، وفيه هدف واضح.
تعريف Definition of Done مخصص لمشاريع الـ Data Science
حدد معايير واضحة: نسبة دقة مستهدفة، حجم Dataset المستخدم في الاختبار، معيار Accuracy Metric المتفق عليه. لا تترك "النموذج يعمل" تحكيمًا للحظ.
Cadence ثنائي المستوى
عمل Sprint للتخطيط على مستوى الفريق ومزامنة التوقعات مع الـ Stakeholders،
وعمل Kanban على مستوى المهام اليومية للفريق التقني.
الخلاصة
الـ Sprints ليست كافية وحدها في مشاريع Data Science.
لكن التخلي عن Agile ليس الحل. الحل هو معرفة متى تستخدم Sprints، ومتى تتركها وتنتقل إلى Kanban، ومتى تمزج بينهما بوعي.
الـ Agile مبدأ تكيّف، لا قالب تتبعه. وهذا هو جوهر الفارق.
💡 للقراءة والاستزادة: إذا كنت تقود فريق Data Science وتبحث عن إطار عملي، اطّلع على مقاربة CRISP-DM كإطار تكاملي مع Agile، وابحث عن مفهوم "Agile for Data Science" في كتاب Agile Data Science 2.0 لـ Russell Jurney. نقطة انطلاق قوية وعملية.